Diagnostiquer
Note de méthodologie, pas un journal d'incidents — voir docs/troubleshooting.md pour les symptômes déjà diagnostiqués. À lire en premier ; les techniques ci-dessous ne servent que si le symptôme n'y est pas déjà documenté.
Où regarder
- Logs ESPHome en direct (
python tools/tab5_logs.py --host <ip> --config-ha <dossier de configuration de HA>depuis la 3.0, qui lit la clé API que garde Home Assistant ;esphome logsne trouve plus de clé dans le YAML) — source de vérité principale pour les problèmes de séquence de boot, l'état des connexions API, et toute ligneESP_LOG*du code C++. Fermer la session une fois terminée ; un process de logs oublié occupe une connexion API indéfiniment (voir "connexions API épuisées" danstroubleshooting.md). - La Console Système à l'écran (
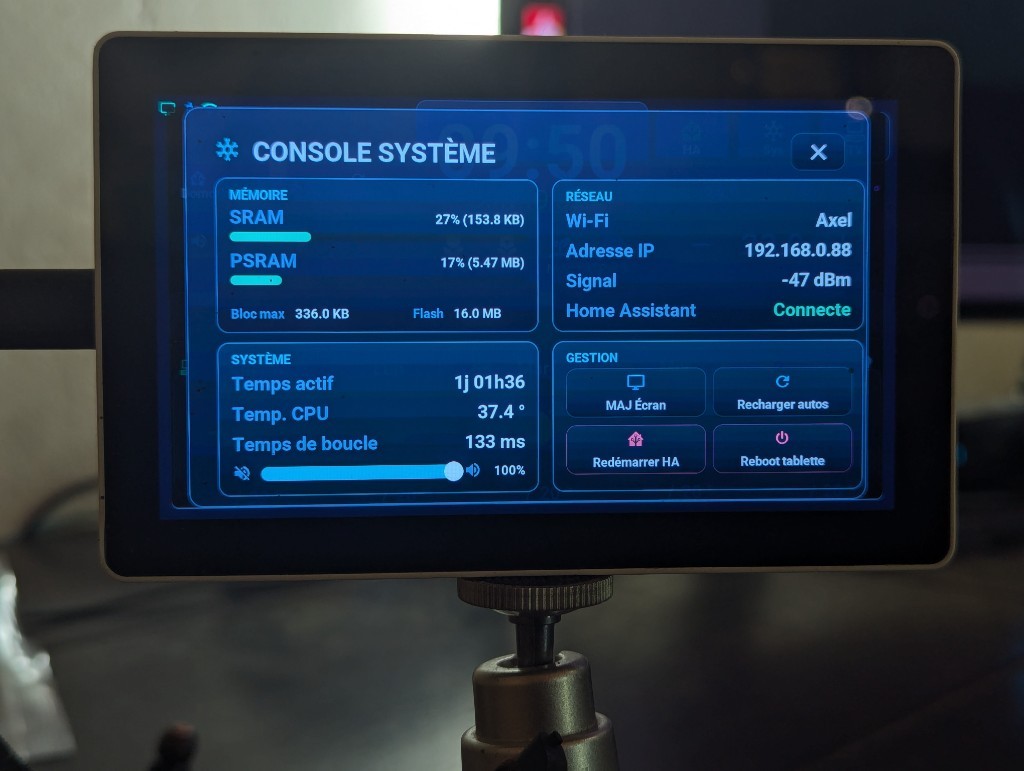
console_sys.yaml, page Système du popup Réglages depuis le 08/10/2026, ouverte directement par un appui long sur le bouton engrenagebtn_control_console, en haut à droite — un tap ouvre les réglages sur leur page Écran ; plus par swipe depuis la refonte du 14/07/2026) — 4 cartes : MÉMOIRE (SRAM/PSRAM, bloc max, flash), RÉSEAU (SSID/IP/signal + état connexion HA), SYSTÈME (uptime, température CPU, charge CPU de chaque cœur, temps de boucle, batterie de la tablette, volume) et GESTION (MAJ écran = l'automatisation de poussée complète relancée, reload des automations, redémarrage HA et reboot tablette — les deux derniers derrière un overlay de confirmation, refonte du 16/07/2026). Ce n'est pas un visualiseur de logs — pour les payloads/événements, utilisertools/tab5_logs.py.
- Les logs Home Assistant pour tout ce qui est en amont de l'appareil — évaluation trigger/condition d'automation, erreurs de rendu de template, rejets d'appel de service.
Voir l'écran sans la tablette
Le job CI « Rendu hors tablette » (.github/workflows/rendu-host.yml, ADR-0021) compile l'interface pour la plateforme host d'ESPHome (tab5-rendu-host.yaml), la lance sur le runner, lui pousse les scènes du mode démo, puis ouvre un à un les ~80 écrans de tools/rendu/ecrans.py (fenêtres, sous-fenêtres, Arcade, menus et parties des jeux) avec un doigt virtuel, comme sur la dalle. Une image par écran, dans les sept langues (une tâche par langue). Sur une pull request qui touche l'écran, il dit quels écrans ont changé par rapport à main et joint les images avant/après (artefact rendu-captures, dossier diff/). Il ne bloque pas la PR. Deux tâches échouent sur un écart : « clair » et « galerie » (chaque thème, dans les deux modes) comparent une bascule de thème à chaud et un démarrage à froid, au pixel près.
- Un changement voulu : rien à faire pour les écrans,
maindevient la référence une fois la PR mergée. Pour les scènes de la galerie descreens.md:python tools/rendu/maj_references.py --run <id du run>remplacedocs/images/rendu/; relire les images, puis committer. - Un nouvel écran : une entrée dans
tools/rendu/ecrans.py(appuis aux coordonnées des captures, paysage 1280×720). « Une capture identique à … » dans le run veut dire qu'un appui est tombé à côté. - Mise au point d'un écran : Actions → Rendu hors tablette → Run workflow, champ « seulement » (noms d'écrans) et « langues » (par ex.
["de"]). - Il ne tourne que sous Linux ou macOS (plateforme
host) : sous Windows, passer par la CI (Actions → Rendu hors tablette → Run workflow). - Il montre la mise en page, pas l'appareil : ni tactile, ni son, ni assistant vocal, ni temps de rendu ou mémoire.
Marquer un point d'observation dans le code
Utiliser le tag [AI-DEBUG] (voir Tab5/README.md) en commentaire quand on trouve un bon point d'observation en cours d'investigation, même sans corriger le problème sous-jacent dans la même session.
Après un plantage ou une coupure Wi-Fi : le journal des démarrages
Depuis le 26/09/2026, l'appareil tient son propre journal (Tab5/ecran/tab5_journal.cpp). Un plantage ou une panne du lien avec le co-processeur Wi-Fi (ESP32-C6) s'analyse donc après coup, sans câble USB branché au moment de l'incident :
- Ce qui est gardé : toutes les erreurs (d'ESPHome et d'ESP-IDF, dont le pilote ESP-Hosted du C6, étiquette
esp-idf), plus les avertissements écrits pendant que Home Assistant n'est pas connecté (démarrage avant HA, Wi-Fi tombé). Une ligne répétée d'affilée est comptée, pas recopiée. Le rapport de plantage d'ESPHome (étiquetteesp32.crash: PC, adresse fautive et pile d'appels des deux cœurs) est écrit par le logger avant que le déclencheuron_messagedu journal existe : il n'y entrait donc jamais seul. Depuis le 06/10/2026, le journal le lit (esp32::crash_handler_has_data()), le rejoue dans ses lignes quand la raison du reset est un plantage, et l'efface une fois le journal arrivé à HA (comme ESPHome après un abonnement aux logs). - Les avertissements d'ESP-IDF ne sont pas dans le firmware : ESPHome compile ESP-IDF avec son niveau de journal à ERROR par défaut (
esp32: framework: log_level, d'oùCONFIG_LOG_MAXIMUM_LEVEL=1) : les lignesESP_LOGWetESP_LOGId'ESP-IDF et d'ESP-Hosted sont retirées à la compilation et ne se voient ni dans le journal ni sur le port série. Le contrôle de version du C6 par ESP-Hosted en fait partie (voir Matériel). L'absence d'un tel avertissement ne prouve donc rien. Les erreurs restent, dont un délai RPC dépassé d'ESP-Hosted (Response not received for …, ouError reported: Response Timeoutpour une requête asynchrone). Pour voir les avertissements, il faudrait un build d'essai aveclog_level: WARNsousesp32: framework:(pas essayé). Trouvé en répondant à la discussion #369. - Où : 32 lignes en RAM
.noinit, qui survit aux redémarrages logiciels, aux plantages, aux chiens de garde et au reset par l'USB, pas à une coupure de courant. Quand le Wi-Fi manque depuis 90 s, une copie part en NVS (au plus toutes les 15 min, seulement s'il y a du nouveau), relue au démarrage suivant si la RAM a été perdue. - Comment il arrive : à chaque connexion de HA, l'événement
esphome.tab5_journalpart pour un reset anormal ou un rapport de plantage, un Wi-Fi absent 90 s ou plus, un démarrage qui n'a jamais joint HA, une erreur après la connexion à HA, ou HA joint plus de 90 s après le démarrage. Les lignes d'avant la première connexion à HA ne sont que du contexte (le lien ESP-Hosted est normalement « not yet up » une fois à chaque démarrage, 7 à 12 s après) : un démarrage normal n'envoie rien. La garde (e) deHomeAssistant_Config/packages/tab5_health.yamlen fait une notification persistante (et une notification sur le téléphone sigrave: reset anormal, plantage, ou Wi-Fi absent 90 s). Les événements restent dans la tableeventsdu recorder. - Raison de chaque démarrage : l'entité
Tab5 Raison du redémarrage(Software Reset,Exception,Task Watchdog,Brownout,Power On…), une ligne par démarrage dans l'historique HA. - Chronologie de chaque démarrage (prochaine version) : les entités
Tab5 Chronologie du démarrageetTab5 Chronologie du démarrage (suite), l'instant en ms de chaque étape, des constructeurs C++ à la fin desetup()(bandes de priorité, séquenceon_boot) puis après (rétroéclairage, première image, Wi-Fi, API, chargeur de la batterie) — comment les lire dans performances. - La fiabilité au-delà des quelques jours du recorder (depuis le 09/10/2026) : l'historique de HA ne garde les états que quelques jours, et ni
Tab5 Uptime(un horodatage) ni la raison du démarrage (un texte) n'ont de statistiques.packages/tab5_health.yamlajoute trois capteurs àstate_class, dont HA garde les statistiques longue durée sans limite de temps : « Tab5 · redémarrages » (chaque redémarrage que reconnaît la garde « reboot inattendu », demandé ou non), « Tab5 · redémarrages inattendus » (ceux que cette garde notifie) et « Tab5 · fonctionnement continu » (heures depuis le dernier démarrage, toutes les 15 min ; le maximum d'une journée est sa plus longue période sans redémarrage). Les lire dans Outils de développement → Statistiques, ou avec une carte « Graphique de statistiques » (variation sur une semaine ou un mois pour les compteurs, maximum pour la durée). Une coupure Wi-Fi sans redémarrage, un redémarrage de HA ou l'arrivée de la tablette dans HA ne comptent pas. - Chien de garde sans rapport de plantage = le bouton d'alimentation (depuis le 06/10/2026) : un appui court sur le bouton d'alimentation redémarre la tablette avec
ESP_RST_WDT, sans rapportesp32.crash. Le journal l'appelle « bouton d'alimentation ou chien de garde RTC (rst 0x..) » et n'envoie rien ; l'entité affichePower button or RTC watchdog (rst 0x..)au lieu du texte d'ESPHome, qui pour cette raison répète la source du dernier redémarrage demandé (Reboot request from esphome.ota: ESPHome ne l'efface jamais).rst 0x..est le code de reset du ROM (esp_rom_get_reset_reason(0); sur l'ESP32-P4,ESP_RST_WDTregroupe 0x07 et 0x0B, chiens de garde des groupes de timers, 0x09, 0x0D et 0x10, chien de garde RTC, 0x12, super chien de garde). La même raison avec un rapport de plantage reste un plantage et alerte toujours (Crash, other watchdogs (rst 0x..)). Ce qui n'alerte plus : un démarrage bloqué plus de 9 s (chien de garde RTC du bootloader) et un chien de garde de timer qui réinitialise sans passer par la panique ; les deux restent visibles dans l'historique de l'entité. Raisonnement et sources dans l'[AI-WARNING]deTab5/ecran/tab5_journal.cpp. - Décoder une pile d'appels : les adresses appartiennent au build qui a planté. Pour un build local, garder son ELF (
H:/.esphome_data/build/tab5-ha-hmi/build/tab5-ha-hmi.elf, comparer leconfig_hash) ; pour un firmware publié, prendre l'artefactelf-<révision>de son run « Publication » (gardé 90 jours), ou le recompiler par Run workflow, tag etelf_seulement(le run vérifie que le code est celui publié). Puisriscv32-esp-elf-addr2line -pfiaC -e <elf> <adresses>, outools/capture_serie.py --relire … --elf …. Si le rapport dit captured by a different firmware build, prendre l'ELF de ce build-là. - Écarté volontairement : le core dump d'ESP-IDF en flash. Il lui faut une partition
coredump; la table actuelle (partitions.csv: 2 × 7,75 Mo d'application + 448 Ko de NVS) remplit les 16 Mo, et une table de partitions ne s'écrit que par un flash USB, jamais par OTA. Le journal couvre le cas du C6, qui n'est pas un plantage du P4.
Capturer un plantage sur le port série
Quand le journal dit « plantage (exception) » sans rapport (vu la première fois à la fin d'une mise à jour depuis HA, 3.0.0-rc.1 → rc.2, le 27/09/2026), la sortie de panique d'ESP-IDF est partie au seul endroit où elle s'écrit : la console USB (CONFIG_ESP_CONSOLE_USB_SERIAL_JTAG), juste avant le redémarrage.
- Tablette branchée au PC en USB-C.
python tools/capture_serie.pyliste les appareils Espressif et refuse de deviner : donner--mac(la MAC de la tablette est son numéro de série USB) ou--port. python tools/capture_serie.py --mac <MAC>: écoute jusqu'à 10 min sans réinitialiser la tablette (DTR et RTS coupés avant l'ouverture), écritcapture-serie-<date>.logau fil de l'eau, s'arrête 60 s après un redémarrage.- Provoquer l'événement (par exemple Installer sur l'entité « Firmware » dans HA).
- Lire le résumé : bloc de panique, redémarrages, rapport de plantage d'ESPHome, adresses. Décoder avec l'ELF du firmware qui a planté (celui d'avant la mise à jour) :
python tools/capture_serie.py --relire capture-serie-….log --elf tab5-ha-hmi-st7123.elf.
Ne jamais ouvrir un autre appareil Espressif branché au même PC. Fermer la fenêtre d'ESP Web Tools (Chrome) redémarre la tablette une fois.
Diagnostiquer un échec silencieux d'automation côté Home Assistant
Si une automation HA ne semble rien faire — pas d'erreur, pas de résultat attendu — et qu'on soupçonne qu'une étape échoue à la validation ou qu'une condition est silencieusement fausse, insérer un marqueur de debug directement dans la vraie automation plutôt que d'essayer de reproduire sa logique dans un script de test isolé.
Concrètement : ajouter un appel input_text.set_value (ou effet de bord similaire, visible et peu coûteux) comme étape supplémentaire au point à vérifier, en utilisant la vraie automation, le vrai trigger, les vrais états d'entités — puis déclencher pour de vrai et relire la valeur.
Une reproduction isolée peut diverger de la vraie automation exactement sur le point qui cause le bug (contexte Jinja différent, disponibilité d'entité différente au moment du trigger, condition qui échoue seulement sur un sous-ensemble d'exécutions) — une repro qui "marche" en isolation ne dit rien sur le pourquoi de l'échec réel. C'est exactement comme ça qu'a été trouvé le bug now() sans strftime sur le calendrier (voir troubleshooting.md) : une repro isolée aurait dû deviner le contexte de template exact, alors que le marqueur dans la vraie automation a fait apparaître l'étape en échec immédiatement.
Retirer ou commenter le marqueur une fois le vrai correctif confirmé — ne pas laisser d'étapes de debug actives en production sans raison.